

 容灾产品
 备份产品
 大数据产品
 云数据管理
如何修复 ORA-26947 Oracle Goldengate 复制未启用
2026-09-20
2026-09-20
2026-09-15
2026-09-15


在运行任何复制命令之前,请先明确你的数据需求和基础设施限制。选错方法可能导致网络延迟、性能问题,甚至数据丢失。
根据以下核心维度评估你的环境,以找到保持 PostgreSQL 数据库同步的正确方式:
使用这个简单框架,根据你的工作负载和工程需求快速选择最佳方案:
| 如果你的目标是…… | 而你的限制是…… | 推荐方法 |
|---|---|---|
| 开发数据库克隆 | 非工作时间执行 | 方法 1:pg_dump / pg_restore |
| 实时报表或数据仓库 | 仅单向同步 | 方法 2:逻辑复制 |
| 预发环境数据刷新 | 特定表、速度快 | 方法 3:pgsync |
| 多主分布式应用 | 主动-主动写入 | 方法 4:pglogical / 双向同步 |
| 高可用性或灾难恢复 | Postgres 版本一致 | 方法 5:物理流复制 |
根据数据规模、网络设置和正常运行时间要求,不同的同步策略适合不同的工作流程。DBA 和后端工程师通常会从以下五种实用方法中选择。
此方法使用 PostgreSQL 原生工具从源数据库导出模式和数据,并将其恢复到目标数据库。
当你不需要持续复制时,它可以提供一个干净、一致的快照。
何时使用
此方法适用于:
当你能够容忍导出和导入过程中的短暂数据间隙时,它是一个不错的选择。
命令演练
运行以下命令将源数据库导出为自定义格式的转储文件:
pg_dump -Fc -h source_host -U db_user -d source_db -f source_backup.dump-Fc 标志输出压缩的自定义格式归档。转储文件准备好后,将其恢复到目标数据库:
pg_restore -v -c --no-owner --no-privileges -h target_host -U db_user -d target_db source_backup.dump-c 标志会在重新创建现有数据库对象之前将其删除。--no-owner 和 --no-privileges 标志可防止源环境和目标环境之间角色不同时出现权限错误。
局限性
此方法不支持实时同步。每次运行都会从头复制完整数据库或选定的模式。对于数百 GB 的数据库,导出和导入时间可能会显著增加,并给 CPU 和磁盘带来沉重负载。
pg_restore 针对存在活动连接的数据库运行,删除命令可能会失败。请在恢复之前终止目标数据库上的活动连接。专业提示
对于大型数据库,目录格式(-Fd)通常比自定义格式(-Fc)更合适。它通过 -j 标志支持并行作业,可同时将转储或恢复拆分到多个表上,在多核系统上可以显著缩短总时间。
PostgreSQL 逻辑复制使用发布-订阅模型。与逐字节复制整个数据库的物理复制不同,逻辑复制以逐表为基础流式传输单个数据变更。
这依赖于 PostgreSQL 读取其预写日志(WAL),即在事务变更提交到磁盘之前按顺序记录这些变更的日志。
系统将这些 WAL 条目解码为逻辑操作(插入、更新、删除),并将其流式传输到订阅者。
要求
你的主数据库应运行 PostgreSQL 10 或更高版本。你还需要在发布者服务器的 postgresql.conf 中调整一些设置:
wal_level:设置为 logical,以写入逻辑解码所需的额外元数据。max_replication_slots:应等于或超过你计划连接的订阅数量。max_wal_senders:应足够高,以覆盖活动复制连接。wal_level 更改为 logical 需要重启数据库,这可能会短暂中断客户端连接。发布者和订阅者语法
你需要先手动将模式从发布者复制到订阅者。逻辑复制不会自动复制模式定义或结构变更。
表结构匹配后,连接到源数据库并创建发布:
CREATE PUBLICATION my_db_pub FOR TABLE customers, orders;如果要改为复制数据库中的每个表,请创建全局发布:
CREATE PUBLICATION my_all_pub FOR ALL TABLES;然后连接到订阅者数据库并创建订阅以开始流式传输变更:
CREATE SUBSCRIPTION my_db_sub
CONNECTION 'host=publisher_host port=5432 dbname=source_db user=repl_user password=repl_pass'
PUBLICATION my_db_pub;
使用场景
逻辑复制非常适合数据整合、实时报表仪表板和零停机大版本升级。
它让工程师能够将多个源服务器的数据聚合到一个统一的数据库中,而无需复制预发或测试表。
局限性
ALTER TABLE 之类的模式变更不会自动复制。请在两个数据库上手动运行匹配的 DDL 命令。UPDATE 和 DELETE 操作将不会被复制。pgsync 是一个专门用于在两个 PostgreSQL 数据库之间同步数据的开源命令行工具。与缓慢的转储或僵化的逻辑复制设置不同,它被设计为快速、可定制且默认安全。
这个 PostgreSQL 数据库同步工具通过高速批量传输工作,而不是永久的流式复制循环,因此是临时任务的轻量级选择。
它是什么
由 Andrew Kane 开发的 pgsync 通过安全连接并行传输表数据。它可以处理目标端的细微模式差异,并允许你同步特定表、行或相关记录组,而不是整个数据库。
安装
pgsync 基于 Ruby 构建,因此你可以使用 RubyGems 或 Homebrew 安装它:
gem install pgsyncbrew install pgsync安装后,在项目文件夹内运行 setup 命令以生成配置文件:
pgsync --init这会创建一个 .pgsync.yml 文件,你可以在其中定义源连接和目标连接、排除特定列或表,以及设置其他默认值。
关键命令
单独运行 pgsync 可同步配置文件中定义的所有表。要仅同步特定表:
pgsync table1,table2该工具还支持通配符,可用于按命名模式同步表:
pgsync "orders_*"要仅复制匹配条件的行,同时保持目标端现有行不变,请添加查询过滤器 --preserve:
pgsync products "where store_id = 5" --preserve如果不使用 --preserve,目标端匹配的行将被覆盖。
安全功能
为防止意外覆盖生产环境,pgsync 将默认目标主机限制为 localhost 或 127.0.0.1。要同步到远程数据库,请先在 .pgsync.yml 文件中添加 to_safe: true。
你还可以通过在配置文件中列出敏感列(如密码或电子邮件地址),确保它们永远不会离开源数据库。
何时选择它而不是其他方法
pgsync 非常适合当你需要一个对开发者友好的工具,用真实生产数据刷新预发环境时。当你只需要一部分表或行时,它比 pg_dump 更快,并且跳过了逻辑复制槽的设置开销。
双向复制允许在两台服务器上写入,通过双向传播变更来保持它们同步。这不是 PostgreSQL 的内置功能。设置它需要像 pglogical 这样的扩展。
为什么双向同步比单向更难
在单向设置中,主数据库是唯一的事实来源。使用双向复制时,两个数据库都接受写入,这会导致数据分歧。
如果两个用户几乎同时在不同服务器上更新同一行,系统将面临写入冲突。处理这些冲突、避免复制循环,以及保持跨节点自增 ID 序列对齐,都是真实的工程挑战。
设置演练
在两台服务器上安装 pglogical 扩展。更新两台服务器上的 postgresql.conf 以加载库并设置复制级别:
wal_level = logical
shared_preload_libraries = 'pglogical'
重启两台服务器上的 PostgreSQL 以应用更改。然后连接到两个数据库并加载扩展:
CREATE EXTENSION pglogical;在服务器 A 上,创建第一个节点:
SELECT pglogical.create_node(
    node_name := 'node_a',
    dsn := 'host=server_a_ip port=5432 dbname=my_db user=repl_user password=pass'
);
将你的表添加到默认复制集:
SELECT pglogical.replication_set_add_all_tables('default', ARRAY['public']);<path d="M16 4h2a2 2 0 0 1 2 2v14a2 2 0 0在服务器 B 上,以相同方式创建第二个节点:
SELECT pglogical.create_node(
    node_name := 'node_b',
    dsn := 'host=server_b_ip port=5432 dbname=my_db user=repl_user password=pass'
);
最后,在两个方向上创建订阅:将服务器 B 订阅到服务器 A,然后将服务器 A 订阅到服务器 B。这种相互设置建立了双向流动,pglogical 会自动处理回环防止。
pglogical 中,序列与表是分开复制的。请将它们显式添加到复制集,否则自增 ID 可能会在节点之间发生冲突。冲突处理策略
当发生写入冲突时,pglogical 根据 pglogical.conflict_resolution 参数决定哪个更新获胜:
last_update_wins:保留具有最新提交时间戳的版本,覆盖较旧的写入。first_update_wins:保留第一个应用的写入,并丢弃传入的冲突变更。error:停止复制并发出警报,以便工程师手动解决冲突。避免冲突的最佳实践
为了保持双向设置稳定,请在设计模式时考虑多主写入:
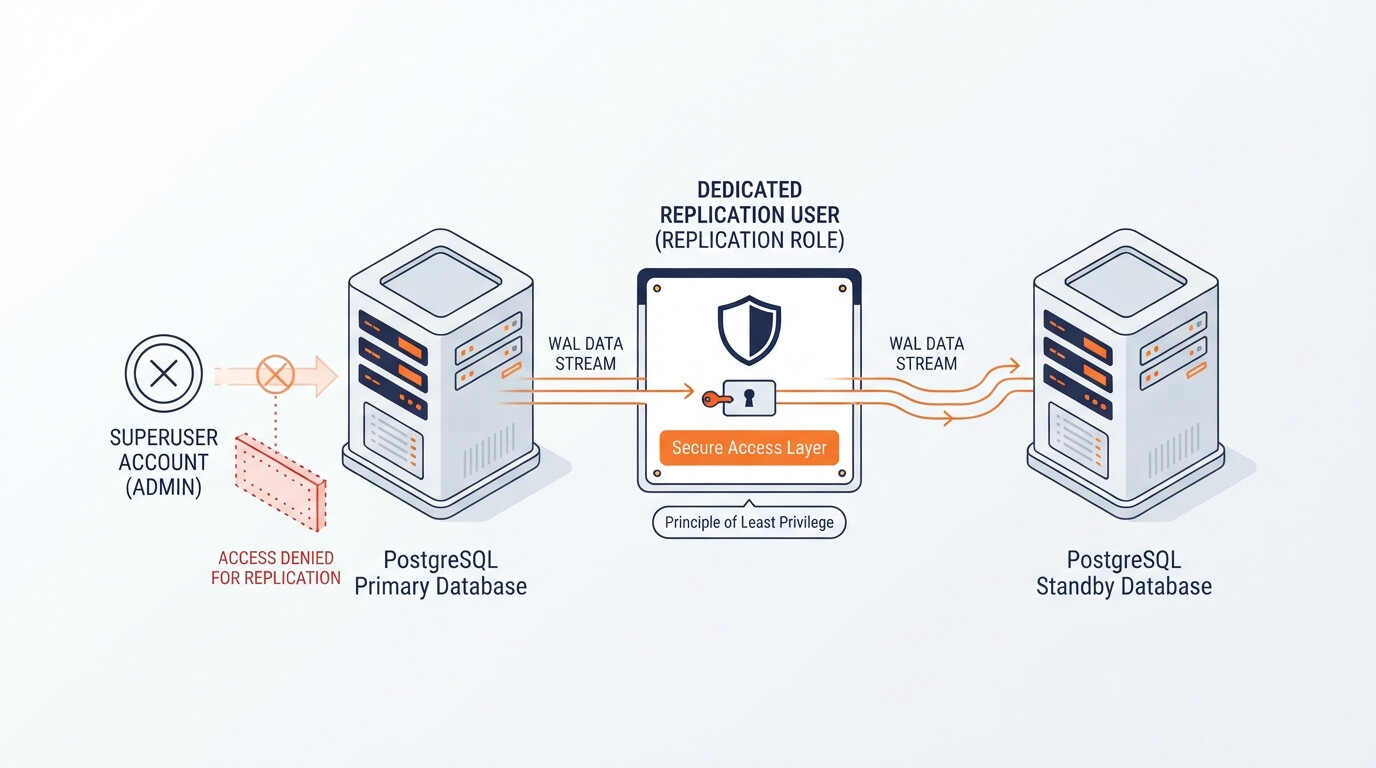
pglogical 不会自动复制 DDL 变更,因此请在维护窗口期间规划和协调模式迁移。物理复制会复制数据库的精确字节级结构。它是实时只读副本、高可用性(HA)和灾难恢复(DR)的行业标准。
物理复制基础
物理复制不像逻辑复制那样流式传输单个表插入等逻辑操作,而是将原始预写日志(WAL)数据从主服务器流式传输到备用服务器。备用服务器接收这些 WAL 变更并直接将其应用到自己的数据库文件。
由于它复制磁盘上的精确数据布局,备用服务器是主服务器的逐字节克隆。在自管理服务器上设置此功能通常涉及运行 pg_basebackup 来复制初始数据,然后在 postgresql.conf 中配置 wal_level = replica 等复制设置。
何时物理复制不是合适的工具
物理复制性能很高,但并非适用于所有同步项目。如果你需要以下情况,请避免使用它:
Azure 和 AWS 托管方案概述
如果你的数据库运行在云中,可以跳过手动管理物理复制。两大主要提供商都为此提供托管服务。
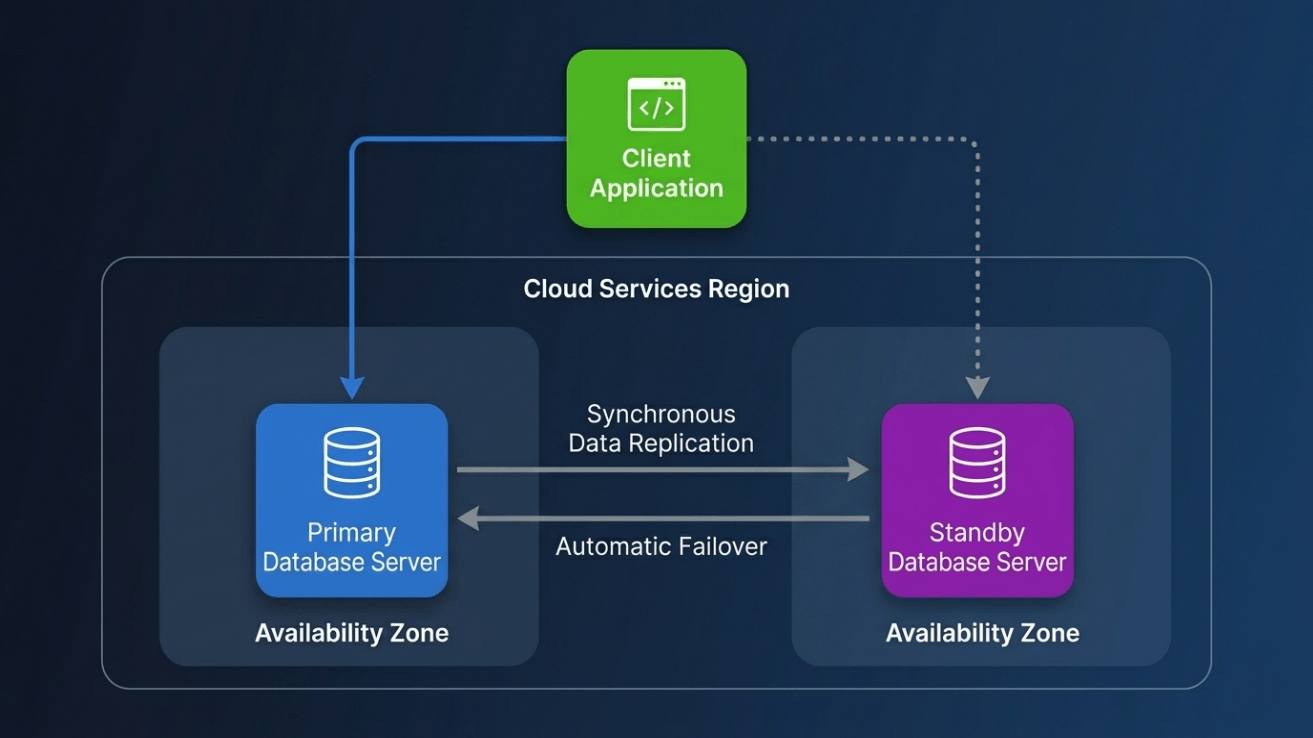
AWS 提供 AWS Database Migration Service(DMS),可以以最小停机时间处理同构和异构数据库迁移。对于 AWS 内的持续复制,RDS for PostgreSQL 只读副本在底层使用相同的物理流复制,包括用于灾难恢复的跨区域选项。
Azure Database for PostgreSQL Flexible Server 为同区域和跨区域设置提供只读副本。跨区域副本有助于在更接近用户的位置提供只读查询,同时提供地理故障转移选项。
物理复制与逻辑复制对比
下表总结了这两种复制方法的核心区别:
| 功能 / 能力 | 物理复制 | 逻辑复制 |
|---|---|---|
| 复制粒度 | 整个服务器实例 | 特定表或数据库 |
| 目标数据库状态 | 只读 | 读写 |
| 跨版本支持 | 否(版本必须匹配) | 是(例如 PostgreSQL 14 到 17) |
| DDL 模式变更 | 自动复制 | 不复制 |
| 写入性能影响 | 开销极低 | 中等开销 |
| 主要用例 | 高可用性、灾难恢复 | 分析、报表、迁移 |
设置同步方法只是工作的一半。你还应确认数据正在正确流式传输、检查复制延迟,并测试辅助数据库是否保持更新。
如果你运行的是逻辑复制,请检查订阅者节点的状态。在订阅者数据库上运行此查询,查看复制工作进程的健康状况:
SELECT subid, subname, pid, received_lsn, latest_end_lsn
FROM pg_stat_subscription;
此视图返回活动逻辑复制工作进程的诊断详细信息:
pid:复制工作进程的进程 ID。如果为 null,则订阅已禁用或存在活动连接故障。received_lsn:订阅者从发布者收到的最新日志序列号(LSN),标记其在 WAL 数据流中的位置。latest_end_lsn:订阅者已完成应用更改的 LSN 位置。如果 received_lsn 和 latest_end_lsn 匹配,则订阅者已跟上传入的 WAL 流。要从发送端监控复制,请查询发布者数据库中的活动传出流。在主服务器上运行:
SELECT application_name, client_addr, state, sent_lsn, write_lsn, flush_lsn, replay_lsn
FROM pg_stat_replication;
此视图为每个已连接的备用服务器或订阅显示一行。state 字段应显示 streaming 表示连接健康。
要以字节为单位计算复制延迟,请使用 pg_wal_lsn_diff() 函数找出 sent_lsn 和 replay_lsn 之间的数值差。
要进行直接的功能测试,请在源数据库中插入一条模拟记录,并确认它到达目标数据库。在主数据库上运行:
INSERT INTO customers (name, email)
VALUES ('Alice', 'alice@example.com');
然后连接到辅助数据库并检查该记录:
SELECT * FROM customers
WHERE email = 'alice@example.com';
如果连接配置正确,该记录应在毫秒内出现在目标表中。
测试插入是一个好的开始,但你还应测试 UPDATE 和 DELETE 操作。逻辑复制处理这些操作的方式与插入不同,因此这一步很重要。
如果订阅者上的被复制表缺少主键或有效的唯一索引,传入的更新和删除将失败,并可能使复制工作进程停止。运行快速更新测试并检查 PostgreSQL 错误日志,以确认更改无错误地传播。
在移动真实数据库流量或开始同步之前,请遵循这些标准防护措施。此清单可帮助你避免常见同步错误,并降低对数据库性能的风险。
pg_stat_replication 或逻辑槽指标设置主动监控警报,以在延迟影响下游应用之前发现它。sslmode=verify-full)来保护这些数据路径。手动管理多个 PostgreSQL 数据库之间的逻辑复制、冲突解决和复制延迟需要真正的工程时间。本指南中的每种方法都有各自的设置步骤、监控查询和需要跟踪的边缘情况。
i2Stream 是一款企业级数据库复制解决方案,可处理同构和异构数据库(包括 PostgreSQL)之间的实时同步、灾难恢复、迁移和集成。它基于日志解析和流数据处理构建,因此在源端捕获变更而不会给生产数据库增加负载。
pg_stat_replication 查询来检查健康状况。对于还要管理跨数据中心灾难恢复的团队,i2Backup 通过处理这些数据库所运行更广泛基础设施的备份和恢复,与 i2Stream 形成互补。
Q1:同步两个 PostgreSQL 数据库最简单的方法是什么?
pg_dump 和 pg_restore 最适合一次性同步。对于持续同步,原生逻辑复制的设置比双向复制更简单。
Q2:我可以跨不同主要版本同步 PostgreSQL 数据库吗?
可以。物理复制需要版本匹配,但逻辑复制和 pgsync 等工具支持跨版本同步。
Q3:逻辑复制会自动同步模式变更吗?
不会。它只流式传输数据变更。诸如 ALTER TABLE 之类的模式变更需要在两个数据库上手动应用。
Q4:如何检查我的 PostgreSQL 数据库是否已同步?
在订阅者上查询 pg_stat_subscription,在发布者上查询 pg_stat_replication,以检查状态和延迟。测试 INSERT、UPDATE 或 DELETE 也可以确认同步是否正常工作。
Q5:什么会导致 UPDATE 或 DELETE 操作上的复制失败?
订阅者表上缺少主键或唯一索引。如果没有,逻辑复制无法识别要更新或删除哪一行,工作进程会因错误而停止。
Q6:双向复制值得增加复杂性吗?
仅适用于多主、主动-主动设置。它会引入需要主动管理的写入冲突和序列冲突。对于单向同步,逻辑复制或物理复制更易于维护。
同步两个 PostgreSQL 数据库归根结底是将方法与任务相匹配。pg_dump 和 pg_restore 适用于一次性传输,逻辑复制处理持续的单项同步,物理复制仍然是高可用性和灾难恢复的标准。双向设置和 pgsync 等工具填补了多主写入或快速、灵活的预发环境刷新的空白。
无论你选择哪种方法,验证同步和监控复制延迟与初始设置同样重要。对于跨多个数据库或环境管理此工作的团队,英方软件 提供 i2Stream 等工具来简化持续复制并减少所涉及的手动开销。

公告


邮件
销售
 预约演示


 沪公网安备31011202020864号